Lorsque « Chloé » devient « Chloé », repartez du fichier original et choisissez son encodage à l’import. Vérifiez ensuite le séparateur de colonnes et le type des identifiants. Corriger les accents à la main dans une copie déjà convertie peut faire disparaître la preuve nécessaire pour comprendre le problème.
Vous avez reçu un export de profils destiné à une revue ou à votre CRM. Les noms sont lisibles dans un éditeur de texte mais déformés dans le tableur, ou toutes les valeurs arrivent dans une seule colonne. Ce guide sépare ces deux problèmes et fournit un petit fichier français reproductible. Aucun import réel dans Excel, Calc ou un CRM n’est revendiqué : les contrôles réalisés ici sont des lectures de caractères et de structure par un programme local.
Distinguer encodage, séparateur et conversion de type
L’encodage indique comment des octets deviennent des caractères. Le séparateur indique où finissent les champs. Le type indique si une valeur sera gardée comme texte, comprise comme nombre ou interprétée autrement. Trois réglages différents peuvent donc abîmer la même ligne. Un nom mal décodé ne se répare pas en remplaçant la virgule par un point-virgule ; une colonne unique ne se répare pas en ajoutant des accents.
Faites une photographie courte du défaut : nom du fichier, application et méthode d’ouverture, nombre de colonnes attendu et exemple précis. Gardez l’original dans un emplacement approprié aux données. Une capture montrant un affichage défectueux aide à expliquer le symptôme, mais le fichier brut reste nécessaire pour comprendre les valeurs disponibles.
Si le problème touche seulement le tableur, évitez d’enregistrer sur l’original « pour voir ». Si le fichier brut montre déjà des points d’interrogation ou des caractères remplacés, cherchez une exportation antérieure. Le bon réglage d’affichage ne peut pas recréer une lettre qui n’existe plus dans les octets conservés.
Un fichier français de trois lignes à contrôler
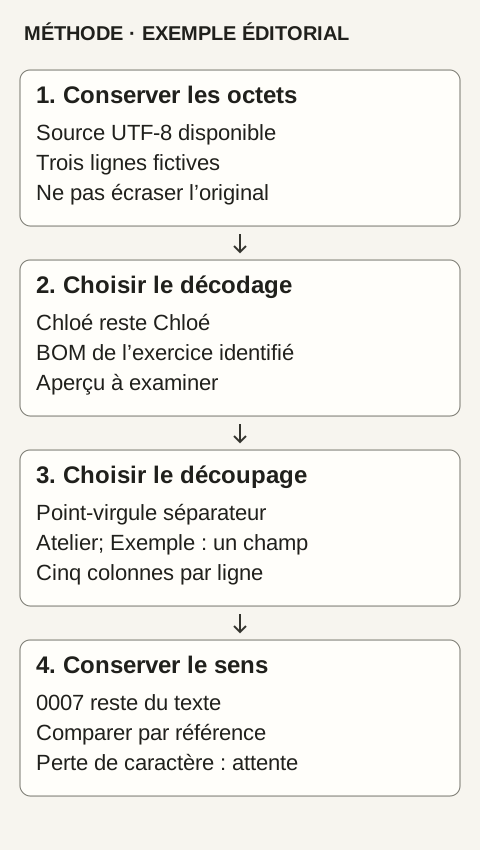
Les personnes et sociétés de cet exercice sont entièrement fictives. Le fichier contient cinq colonnes : référence, nom, société, observation et pays. La référence est une chaîne comportant des zéros initiaux. Le point-virgule sépare les champs ; les guillemets protègent le point-virgule contenu dans le nom d’une société. Cette convention est celle de l’exercice, pas une obligation pour tous les CSV français.
reference;nom;societe;observation;pays
0007;Chloé Démo;"Atelier; Exemple";À vérifier;France
0008;Maël Exemple;Élan Démonstration;Rôle à confirmer;Belgique
0009;François Fictif;Bureau Démo;Source conservée;France
Télécharger le CSV fictif UTF-8 avec marque BOM. La marque BOM est présente dans cette copie pour l’exercice ; elle ne constitue pas une correction du contenu. Le lecteur local a vérifié trois enregistrements de cinq champs, les références 0007 à 0009 et les noms accentués exacts. Le fichier ne contient ni profil réel, ni email, ni téléphone.
Le contrôle attendu est facile à expliquer à un collègue : Chloé doit garder son accent ; « Atelier; Exemple » doit rester une seule société ; 0007 doit conserver ses quatre caractères. Si deux de ces conditions réussissent et que la troisième échoue, il reste un réglage à reprendre. Une belle première ligne ne valide pas tout le fichier.
Ouvrir la copie avec un choix explicite dans Excel
La documentation française de Microsoft sur les CSV UTF-8 indique qu’un fichier enregistré avec BOM peut être ouvert normalement. Elle propose aussi l’import de données Texte/CSV ou l’assistant d’importation de texte. Cette indication concerne le parcours documenté ; les menus et l’aperçu de votre version restent à vérifier.
Commencez dans Excel, puis utilisez l’import depuis un fichier texte/CSV. Choisissez le fichier de travail, vérifiez l’encodage indiqué et le séparateur observé dans la source. Dans notre exemple, l’aperçu doit afficher cinq champs. Conservez les références comme texte, puis examinez les noms et la société qui comporte un point-virgule. Chargez seulement après cette lecture.
La documentation d’import et d’export de Microsoft distingue plusieurs méthodes et explique que le séparateur peut varier. Il n’est donc pas nécessaire de modifier les paramètres régionaux de toute la machine pour faire passer un seul fichier. Préférez un réglage explicite pour ce transfert lorsque votre méthode d’import le permet.
Lire le même exercice dans LibreOffice Calc
L’aide française de Calc distingue le jeu de caractères, le séparateur et le type de colonne Texte. Pour l’exercice, sélectionnez UTF-8, le point-virgule et le guillemet comme délimiteur de texte. Le choix Texte pour la référence préserve son sens d’identifiant plutôt que de quantité. Vérifiez l’aperçu avant de poursuivre.
Un champ vide doit aussi garder sa place. Ne cochez pas une option de regroupement des séparateurs uniquement pour « simplifier » l’affichage : vous devez d’abord comprendre si deux séparateurs successifs représentent une valeur manquante attendue. Une colonne vide entre le nom et le pays n’autorise pas à déplacer le pays dans le champ société.
Le choix de la langue peut intervenir dans la lecture des nombres ou dates. Il ne remplace pas le choix d’encodage. Si votre fichier contient des dates ambiguës, définissez leur format séparément plutôt que de considérer qu’un nom bien affiché prouve la bonne interprétation de toute la ligne.
Comprendre une corruption réversible sans la généraliser
Dans notre démonstration locale, le caractère é s’encode en UTF-8 avec les octets hexadécimaux C3 A9. Lire ces mêmes octets selon Windows-1252 produit l’affichage é. Le programme de vérification reproduit ce décalage sur « Chloé Démo », puis retrouve le texte de départ en inversant précisément cette transformation connue. Ce résultat mathématique concerne cet exemple, sans établir l’encodage de votre export.
Cette distinction compte lors d’une reprise. Si le fichier original contient toujours les bons octets, l’import correct suffit. Si quelqu’un a enregistré l’affichage erroné comme nouveau texte, vous avez une couche de transformation supplémentaire. Si une étape a remplacé des caractères par ? ou par le caractère de remplacement �, plusieurs entrées originales peuvent produire la même sortie : l’inversion n’est plus démontrée.
Une règle globale « remplacer é par é » peut aussi modifier une chaîne qui contenait réellement ces caractères. Avant toute correction de masse, établissez la transformation, vérifiez-la sur plusieurs cas distincts et gardez la version précédente. Si vous ne pouvez pas expliquer comment une valeur a été produite, mettez-la en attente plutôt que de la déclarer réparée.
Comparer les valeurs et les comptes après le passage
Relisez une copie exportée du tableur avec la même convention de séparateur et d’encodage, puis comparez-la à la source sur des clés stables. Dans cet exercice, les références servent à comparer les noms et sociétés. Vous devez retrouver trois références distinctes et cinq champs par ligne. Un tri peut changer l’ordre ; il ne doit pas décider quelle personne est reliée à quelle société.
| Observation | Cause à examiner | Reprise utile |
|---|---|---|
| Chloé au lieu de Chloé | Décodage ou transformation antérieure | Repartir des octets de la source conservée |
| Toute la ligne dans une cellule | Séparateur non reconnu | Revoir le découpage, pas l’orthographe |
| Atelier et Exemple dans deux colonnes | Guillemets ou délimiteur | Vérifier la syntaxe et l’aperçu |
| 7 au lieu de 0007 | Conversion de type | Réimporter la référence comme texte depuis la source |
Ne corrigez pas les identités en retirant tous les accents pour faciliter la comparaison. Le rapprochement de deux observations est une autre décision, qui peut demander une source et une clé fiables. Le guide de rapprochement d’enrichissement, en anglais conserve les observations concurrentes au lieu de trancher à partir de l’apparence d’un nom.
Livrer une convention que le prochain lecteur comprend
Accompagnez le fichier de travail d’une note très courte : UTF-8 avec ou sans BOM, séparateur choisi, délimiteur de texte, colonnes gardées en texte et contrôles effectués. Précisez si la validation concerne un programme local ou une application réellement utilisée. Une relecture de trois lignes synthétiques ne garantit pas le résultat sur une base entière, ni le comportement d’un importeur CRM.
Conservez une liste des anomalies avec leurs références. Les lignes dont la source est récupérable peuvent être reprises ; les autres restent à vérifier. Un décompte honnête distingue les lignes d’origine, les lignes corrigées avec preuve et les lignes dont une valeur demeure inconnue. Ne transformez pas ces inconnues en noms simplifiés pour atteindre un objectif de volume.
Si vous disposez déjà des profils adaptés, terminez cette préparation. Lorsque la source manque réellement, l’extracteur Leadsforlinked propose 100 profils gratuits une seule fois à l’inscription, par lots de 20, avec export CSV et sans carte bancaire. Ce parcours fournit un échantillon à inspecter ; il ne remplace pas votre choix de décodage et de format dans le logiciel de destination.
Sources et portée
Sources consultées le 7 novembre 2026. Les exemples et les schémas sont originaux ; les données fictives ne décrivent aucun client. Les vérifications locales portent seulement sur les fichiers ou calculs indiqués, sans essai dans votre application.
- Microsoft : ouvrir correctement les fichiers CSV UTF-8 — BOM et parcours d’import documentés ; aucune ouverture Excel réalisée ici.
- Microsoft : importer ou exporter des fichiers texte — Méthodes d’ouverture/import et variation des séparateurs ; ne pas imposer une convention française unique.
- LibreOffice : Import de texte — Jeu de caractères, séparateurs, type Texte et option Évaluer les formules. Parcours documenté, sans test dans Calc.
- Leadsforlinked : extracteur et parcours de profils — Offre normale liée au fichier de départ : 100 profils une fois à l’inscription, lots de 20, CSV, sans carte ; ne certifie ni sûreté du texte ni import.